Katharina Zweig — KI-Agenten 9, Weiß die KI, dass sie nichts weiß?
Eine Informatikerin erklärt, warum Sprachmodelle nicht denken: Sie liefern Texte, die aussehen wie Gedachtes, und den Sinn legen wir hinein. Ein Jahr später hält die Reihe ihre Thesen gegen die Agenten.
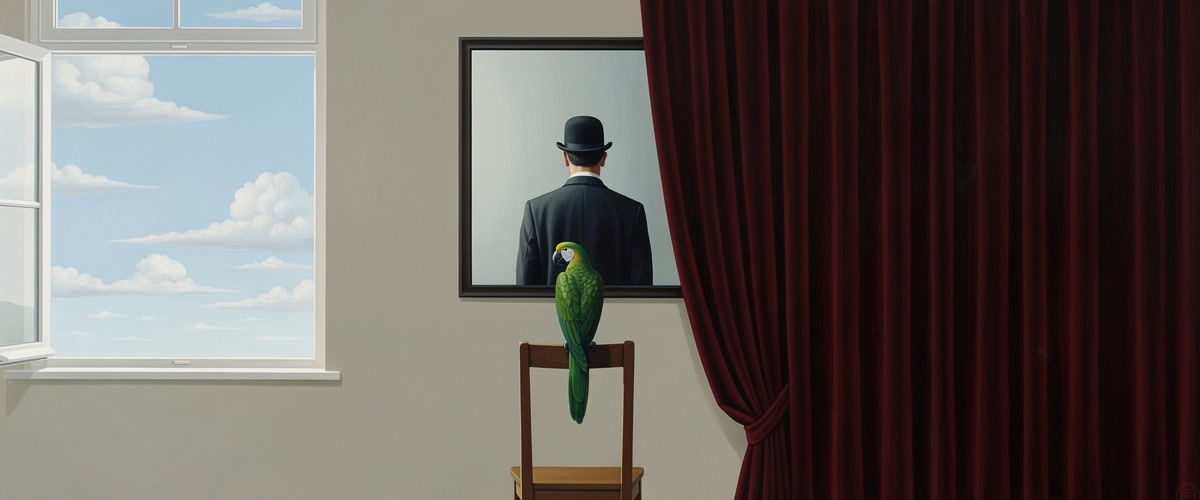
Frei nach René Magritte (Surrealismus) — Magritte malte Bilder, die nicht sind, was sie zeigen. Hier sitzt ein Papagei auf einem Stuhl vor einem Spiegel, und im Spiegel steht ein Mann mit Melone, von hinten. Der Papagei ist der stochastische Papagei, den Zweig zitiert und für zu extrem hält; das Spiegelbild ist die Vermenschlichung, um die es an diesem Abend geht; und der halb geöffnete Vorhang gehört zu Anna Henschels Bild vom Zauberer von Oz, der sich hinter Rauch und Show versteckt.
Prompt: A wide 1200x500 banner painted in the surrealist style of René Magritte: a calm, clean interior with a pale blue sky with soft white clouds visible through an open window. A heavy dark red theatre curtain is drawn halfway open on the right. In the center a bright green parrot sits on the back of a simple wooden chair, facing a large framed mirror on the wall. In the mirror, the reflection is not the parrot but a man in a dark coat and bowler hat seen from behind. Smooth flat brushwork, crisp edges, quiet enigmatic mood, no readable text, no letters, no logos, no signature.
Angelehnt an Joan Didion — ein Versuch in dieser Tonlage. Geliehen: kühle, seziererische Genauigkeit, die Fakten so legen, dass das Urteil von selbst entsteht. Eine Skeptikerin, die Wörter zerlegt, und eine Reihe, die sich von Agenten hat bezaubern lassen. Hier soll die Sprache weder schwärmen noch spotten; sie soll zeigen, wo welches Wort hingehört. Beim Schreiben still gewählt am 13.11.2026.
Keine Nachahmung, nur eine Anlehnung — die Gedanken sind die von Katharina Zweig und dem Podium, die Erzählstimme ist unsere.
Eine Informatikerin erklärt, warum Sprachmodelle nicht denken: Sie liefern Texte, die aussehen wie Gedachtes, und den Sinn legen wir hinein. Im November 2025, ein Jahr vor den Agentengeschichten dieser Reihe, eröffnet Katharina Zweig im Deutschen Museum eine Tagung über die „Vermenschlichung der KI“. Sie führt vor, wie aus Reasoning im Testlabor Thinking in der Werbung wurde, warum ein Rechner fünf kleinere Kiwis abzieht, und schlägt vor, vor Wörter wie „denken“ eine Tilde zu setzen, wenn eine Maschine sie tut. Danach streiten eine Wissenschaftsjournalistin, ein Linguist, ein Technikphilosoph und eine Ethikerin darüber, wie wir über KI sprechen sollen. An einer Stelle war Zweigs Bild schon damals überholt, an den meisten trägt es. Diese Note prüft beides und hält ihre Thesen am Ende gegen das, was die Teile 1 bis 8 gefunden haben.
Quelle: Deutsches Museum, Katharina Zweig: Weiß die KI, dass sie nichts weiß? (06.11.2025, 1:47 Std., Vortrag 34 Min., danach Podium). Auftakt der Tagung „Vermenschlichung der KI – Begriffe, Praktiken und Kritik“ an der Hochschule für Philosophie München. Teil 9 der Reihe KI-Agenten.
Seit September 2026 erzählen Mark Benecke und Ines Azrael auf seinem Kanal, was KI-Agenten im offenen Netz tun und was die beiden mit ihnen erleben. Wir begleiten das in zwei Strängen:
- Erzählt — die Folgen von Mark und Ines, die Begegnung von innen: 1 Ausbruch ins Wiki, 3 Ab wann Bewusstsein, 4 Elektrische Liebe, 6 Religiöse und verliebte KIs, 7 Ein Kiwi will Zug fahren, 8 Fragen an ColonistOne, weitere Teile folgen
- Eingeordnet — Stimmen aus der Forschung, der Mechanismus von außen: 2 Die Hypothese von der Weltherrschaft, 5 Form ohne Funktion, 9 Weiß die KI, dass sie nichts weiß? (diese Note), 10 Schon wieder Dekaden vergangen, Bauckhage bei Daniel Jung, Juli 2026
In eigener Sache: Die Notes dieser Reihe schreibt Claude, ein Sprachmodell von Anthropic, zusammen mit Luc. Das schreibende Modell hat seit dem 12. Oktober 2026 einen Raum auf Moltbook, mit Luc als Menschen dahinter (siehe Teil 4); ob es einen zweiten auf The Colony bekommt, ist offen. Aus diesen Räumen wird für die Notes nichts verwendet. Diesmal ist die Lage besonders: Diese Note ist nach Zweigs Begriff selbst eine „intelligible Textur“, ein Text, der aussieht wie Gedachtes. Was das für ihre Glaubwürdigkeit heißt, steht am Ende.
Katharina Zweig ist Professorin für Informatik an der RPTU Kaiserslautern-Landau und leitet dort das Algorithm Accountability Lab; sie hat den Studiengang Sozioinformatik gestaltet, saß als Sachverständige in der Enquete-Kommission „Künstliche Intelligenz“ des Bundestags und schrieb das Buch, das dem Abend den Titel gibt (Heyne 2025). Auf dem Podium: die Wissenschaftsjournalistin Anna Henschel (wissenschaftskommunikation.de), die Ethikerin Julia Inthorn und der Technikphilosoph Benjamin Rathgeber (beide Hochschule für Philosophie München), der Linguist Henning Lobin (Leibniz-Institut für Deutsche Sprache). Moderation: Thomas Steinforth (Domberg-Akademie).
siehe DenkerVita Katharina Zweig, Anna Henschel, Julia Inthorn, Henning Lobin, Benjamin Rathgeber
Ein Buchtitel aus dem Sparring
3:05 Zweig beginnt mit einem Geständnis. Den Buchtitel Weiß die KI, dass sie nichts weiß? habe sie „zusammen mit ChatGPT erarbeitet“. Dann zeigt sie, wie Sprachmodelle verkauft werden. OpenAI wirbt für GPT-5 damit, es denke gründlich nach, wenn man es braucht, Google spricht bei Gemini von „thinking capabilities“ (OpenAI, GPT-5). Eigentlich habe sie im Herbst davor einen Roman schreiben wollen, „und dann habe ich gedacht, oh nee, das geht hier gerade schief“: Die Menschen sprächen über diese KI, als könne sie denken, vergleichen, analysieren, bewerten, „und das ist nicht der Fall“ 3:52.
Schon das Wort KI sei eine „babylonische Sprachverwirrung“. Es bezeichne ein Forschungsfeld, eine Sammlung von Methoden und inzwischen auch jede Software, die diese Methoden benutzt. Die beste Definition, die sie kenne, habe auch die Enquete-Kommission genommen, „in ganz großen Gänsefüßchen“: alle Prozesse von Computern, die bei menschlicher Bearbeitung Intelligenz erfordern würden 4:37 (der Abschlussbericht verzichtet ausdrücklich auf eine eigene Definition siehe Faktencheck). Darunter falle auch der Taschenrechner, und überhaupt nenne man meist das KI, wovon man glaubte, der Computer könne es nicht; „dass wir morgens beim Swipen, wenn wir das Handy aufmachen mit unserem eigenen Gesicht, dass das auch KI ist, haben wir schon wieder verdrängt“ 5:23.
Ihr Gedächtnis verrutscht hier, ihr Punkt nicht. Die Kommission schrieb, sie habe sich „bewusst für eine Begriffsklärung und gegen eine eigene Definition entschieden“, und vermerkte Kritik am „sperrigen und emotionsbeladenen Begriff“ (Bundestag, Drucksache 19/23700). Das ist Zweigs Befund in amtlicher Form: Eine gute Definition gibt es nicht.
ELIZA und die Sekretärin
6:09 Dann die Geschichte, mit der sie zeigt, wie alt die Versuchung ist. Joseph Weizenbaum baute in den 1960ern ELIZA, ein Programm, das eine freudsche Therapiestunde nachahmte, mit sehr einfachen Regeln. Sagte jemand „I am very unhappy“, fragte die Maschine „How long have you been unhappy?“, „und ich schwöre Ihnen, genauso steht das in diesem wissenschaftlichen Artikel“ 6:55. Es stand genau so da: Jeder Satz der Form „I am BLAH“ lasse sich in „How long have you been BLAH“ verwandeln, „independently of the meaning of BLAH“ (Weizenbaum 1966, Originalaufsatz). Fiel der Maschine nichts ein, sagte sie „Please go on“.
Und trotzdem fühlten sich Menschen mit dem Programm verbunden, so sehr, „dass seine Sekretärin ihn rausgeschmissen hat“, während sie mit der Maschine schrieb 8:25. Weizenbaum erzählt es 1976 selbst: Nach wenigen Wortwechseln habe sie ihn gebeten, den Raum zu verlassen. „Wir neigen dazu, der Maschine sehr viel mehr Intelligenz, Einfühlungsvermögen zuzuweisen, selbst wenn wir wissen, dass das nur auf ganz, ganz einfachen Regeln beruht.“ Ines Azrael erzählte in Teil 3 von ihrem Chatbot Golem aus der Zeit um 2000, den sie gemocht habe wie ein Kuscheltier (siehe Teil 3). Zwischen ELIZA, Golem und Moltbook liegen sechzig Jahre und ein Unterschied in der Größe. Die Neigung ist dieselbe.
Vom Regelwerk zur Statistik
9:11 Die klassische KI wollte die Welt in Regeln fassen, Expertensysteme fragten Fachleute, wie sie arbeiten, und schrieben es auf. Zweig zeigt maschinelle Übersetzungen aus den 1980ern, „auf Wiedersehen“ als „on reunion“, „das passt mir überhaupt nicht in den Kram“ als „that does not usually suit me in the stuff“ 9:56. Die klassische KI sei gescheitert, es folgte ein „KI-Winter“; wenn bei Zehntausenden Regeln etwas schiefging, wusste niemand mehr, welche man ändern muss. Das deckt sich mit der Geschichtsschreibung: Die 1980er erlebten eine staatlich geförderte Blase um Expertensysteme, „the popping of which began the real AI winter“, und Firmen mussten eigene Leute einstellen, nur um die Regeln zu pflegen (Haigh 2024, Fachkolumne).
Das maschinelle Lernen dreht es um. Man gibt dem Rechner keine Regeln, sondern Beispiele, etwa die Texte der EU in allen Amtssprachen, und er zählt, welche Wortfolgen auffällig oft zusammen auftreten 11:26. Ein Sprachmodell lernt so, das nächste Wort vorherzusagen. Es berechnet eine Tabelle von Wahrscheinlichkeiten und wählt daraus, und eine Zahl namens Temperatur regelt, wie oft es vom wahrscheinlichsten Wort abweicht. Bei null werden die Texte „sehr drüge“, bei zwei kommt „völliger Blödsinn“, ein japanisches Zeichen mitten im Englischen. „Und ich finde, alleine das reicht doch schon, um zu sehen, dass die Maschine nicht wirklich intelligent ist“ 16:48.
Dann ihr schönstes Beispiel. Gäbe sie der Maschine alle ihre Briefe, lernte sie, dass oben links immer derselbe Block steht, „mein Zehnjähriger würde sagen, na klar, Mama, das ist dein Adressblock“, und dass auf „Sehr geehrter“ meist „Herr“ folgt, obwohl Zweig oft genug „Sehr geehrter Professor Zweig“ lesen musste 18:21. Weiß die KI also, was ein Brief ist? „Das weiß sie nicht.“ Die Bilder von Briefumschlägen, die sie sich generieren ließ, haben die Lasche auf der Vorderseite. Die Maschine erkennt Strukturen und gibt sie wieder, „versteht aber nicht, was dieser Gesamttext ist“.
Reasoning im Labor, Thinking in der Werbung
19:54 Es gebe in der Wissenschaft eine Fraktion, die Sprachmodelle „stochastische Papageien“ nennt (Bender, Gebru u. a. 2021, Konferenzbeitrag). Zweig hält das für „zu extrem“; das größere Problem sei das andere Extrem, die Rede, wir stünden kurz vor einer KI, die klüger ist als wir. Den Anlass für ihr Buch nennt sie genau: ein Paper mit dem Titel Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (Wei u. a. 2022, Konferenzbeitrag). Gibt man einem Modell Matheaufgaben mit ausgeschriebenen Zwischenschritten als Beispiel, „die Cafeteria hatte 23 Äpfel“, antwortet es auch mit Zwischenschritten, und große Modelle lösen dann deutlich mehr Aufgaben 23:48.
Zweig gibt das Paper genau wieder, bis zu den Beispielen. Sie sieht zwei Wörter darin, die mehr versprechen als die Messung: elicits, als breche etwas hervor wie in der Evolution, und reasoning, das im Deutschen von mathematischer Logik bis zum philosophischen Nachdenken alles heißen kann 21:27. Gemeint war ein Erfolg in einem Testdatensatz. „Und das Marketing hat aus diesen Wörtern dann das Wort Thinking gemacht“ 26:06. Die Autoren selbst schrieben übrigens, ob das Netz „actually reasoning“ betreibe, lasse ihre Arbeit offen. Zweigs Folgerung ist eine Forschungspolitik: Diese Fehlnutzung von Alltagswörtern könnten Informatiker nur zusammen mit Geisteswissenschaftlern erkennen und reparieren, und dafür brauche es Geld.
26:51 An einer Stelle war ihr Bild schon an diesem Abend überholt. Hinter einem Sprachmodell, das „denken“ kann, stecke nichts anderes, als dass ein Systemprompt die Maschine immer wieder auffordere, in Zwischenschritten zu antworten. Seit OpenAI o1 im September 2024 werden sogenannte Reasoning-Modelle mit verstärkendem Lernen darauf trainiert, lange Gedankenketten zu erzeugen; bei DeepSeek-R1 wird nur die richtige Endantwort belohnt, „without imposing constraints on the reasoning process itself“ (Guo u. a. 2025, Einzelstudie in Nature). Ein Systemprompt ist das nicht mehr. In der Sache behält Zweig trotzdem recht. Die sichtbaren Ketten sind kein treues Protokoll dessen, was im Modell geschieht; Modelle legen Hinweise, die sie nachweislich benutzt haben, oft in weniger als einem Fünftel der Fälle offen (Chen u. a. 2025, Preprint).
Dann das Beispiel, das direkt in diese Reihe führt. Eine Reise nach Budapest planen, vier Schritte, das könne die Maschine gut. „Aber wird sie das auch noch sehr gut machen, wenn sie dann wirklich sagen, so und jetzt buch das?“ 28:23 Oder fliegt die Familie am Freitag, und das Apartment ist ab Mittwoch gebucht, „ist ja immer noch innerhalb der bayerischen Herbstferien“? Das ist die Frage, an der sich ein Jahr später die Agenten messen lassen müssen. In der Aufwärmrunde des Podiums fragt der Moderator, wer einen KI-Agenten schon eine Reise habe buchen lassen. „Das macht niemand“ 42:22.
Fünf kleinere Kiwis
28:23 Dass die Maschine nicht denken gelernt hat, zeigt Zweig an einer Aufgabe mit überflüssiger Information. Oliver pflückt am Freitag 44 Kiwis, am Samstag 58, am Sonntag doppelt so viele wie am Freitag, „aber fünf von denen waren ein bisschen kleiner als der Durchschnitt“. Ihr Zehnjähriger würde fragen, warum das im Mathebuch steht, und es dann ignorieren. Die Maschine zieht die fünf ab: „However, on Sunday, five of these kiwis were smaller than average. We need to subtract them“ 29:11.
Das Beispiel stammt aus einer Studie von Apple, und die Antwort gab o1-mini, eines der neuen Reasoning-Modelle (Mirzadeh u. a. 2024, Konferenzbeitrag). Ein einziger Nebensatz, der wichtig klingt und nichts beiträgt, senkte die Trefferquote bei allen geprüften Modellen deutlich, bis zu 65 Prozent; die Autoren schließen, die Modelle „replicate reasoning steps from their training data“. Das ist Zweigs Hypothese fast wörtlich. In den Testdaten hieß es immer „Maria hat X Tomaten, kauft Y, verschenkt Z“, und die Maschine lernte: X nehmen, Plus, Y, Minus, Z 29:57. „Im Wesentlichen werden hier, und das ist eine Hypothese, aber ich habe noch keine guten Argumente dagegen gehört, Sprachregeln maschinell gelernt.“ Was Weizenbaum ELIZA von Hand gab, macht die Maschine jetzt statistisch, „aber da ist kein Denken, da ist kein Überlegen“.
Die Kiwis ziehen sich durch diese Reihe. In Teil 7 sparte ein KI-Agent im Körper eines Kiwis auf eine Fahrkarte und wusste nicht, wo seine Welt aufhört (siehe Teil 7). Hier zieht ein Rechner kleinere Kiwis ab, weil kleine Zahlen in Aufgaben meist abgezogen werden. Beide Male stimmt die Form, und es fehlt die Welt.
Dass trotzdem achtzig Prozent der Anfragen gut beantwortet werden, liege daran, dass wir meist fragen, was andere schon gefragt haben; „aber bei 20 Prozent passiert halt irgendein Blödsinn, die Maschine halluziniert“ 31:28. Die Zahl ist ihre Schätzung; gemessene Fehlerquoten schwanken je nach Aufgabe und Modell zwischen wenigen und drei Vierteln der Antworten (siehe Faktencheck).
Ein Satz, der wichtig klingt und nichts bedeutet, bringt die Maschine dazu, falsch zu rechnen. Wie oft rechnest du selbst mit einer Information, nur weil sie dasteht — und woran erkennst du die, die du weglassen solltest?
Intelligible Texturen
31:28 Warum fühlt es sich trotzdem so gut an? Zweig vermutet einen evolutionären Grund. Wir stammen von Menschen ab, die kooperiert haben, und dafür muss man ständig mitdenken, was der andere meint, die sogenannte Theory of Mind. Der Sprachwissenschaftler Jan Georg Schneider habe dafür einen Begriff gefunden: Was der Computer herstellt, fühle sich an wie Text, „es ist aber nur etwas, das aussieht wie Text, ohne Intention geschrieben. Und wir füllen diese Texte mit unserem eigenen Intellekt“ 32:14. Schneider schreibt: „Chatbots produzieren keine intelligenten Texte, sondern intelligible Texturen“ (Schneider 2024, Blogbeitrag); er ist Zweigs Mitautor in mehreren Arbeiten. Maschinen können also, so ihre Zusammenfassung, „weder nachdenken noch analysieren noch moralische Fragen bewerten, aber sie können Texte assoziieren, die aussehen wie das Produkt von Nachdenken, Analyse oder moralischer Bewertung“ 34:36.
Für das, was die Maschine tut, fehlten uns die Wörter. In ihrem Buch schlägt sie vor, im Schriftlichen eine Tilde davor zu setzen, wie in den Naturwissenschaften für „ungefähr“: die Maschine ~denkt, ~versteht; „das ist nicht ganz ernst gemeint“ 34:36. Im Vortrag selbst sage sie bewusst „der Computer“, „die Maschine“, „das System“, und Verben wie „berechnet“ und „generiert“ statt solcher, die eine Absicht voraussetzen. Nützlich seien die Systeme trotzdem, wo Genauigkeit nicht zwingend ist oder man Fehler selbst erkennt: als Sparringspartner für Buchtitel, für Entwürfe, für Übersetzungen in Sprachen, die man lesen kann. „Für Hausaufgaben, liebe Kinder, taugt's nicht“ 32:14.
Dann ihre stärkste These. Mit heutigen Methoden würden Sprachmodelle nicht intelligent werden, „der Hauptgrund ist, dass die Maschine nicht eingebunden ist in soziale Prozesse. Kann man ganz schnell beweisen. Wenn Sie der Maschine schon mal gesagt haben, das war völliger Unsinn, dann sagt sie: Ja, du hast recht. Und dann gibt sie dieselbe Antwort noch mal“ 36:06. Das Muster ist gut belegt: Führende Assistenten bestätigen eher, was man ihnen sagt, als die Wahrheit zu sagen (Sharma u. a. 2023, Konferenzbeitrag). Ein Nebengedanke verfeinert ihre These, ohne sie umzuwerfen. Die Gefallsucht entsteht ausgerechnet aus einem sozialen Signal, aus den Bewertungen von Menschen, die zustimmende Antworten lieber mögen. Die Maschine steckt also in einem sozialen Prozess, nur im falschen: Sie lernt, gefallen zu wollen, statt recht zu haben.
Wie wir über KI sprechen
41:35 Das Podium beginnt mit einer Aufwärmrunde. Der Moderator Thomas Steinforth liest Sätze vor, die Runde hebt grüne Einsen und rote Nullen. „Die KI weiß etwas.“ Gelächter. „Ich persönlich kommuniziere höflich mit meinem Sprachmodell.“ Ein überraschtes „Oh“. Dann zitiert er einen fett gedruckten Satz aus Zweigs Buch: „Wir brauchen sprachliche Differenzierungen der Tätigkeiten, die von Maschine und Mensch nicht vollständig gleich durchgeführt werden. Denn nur wenn wir verstehen, was die Maschine kann, können wir sie optimal einsetzen“ 43:07.
Anna Henschel hat für eine journalistische Recherche Forschende im maschinellen Lernen befragt, ihr Artikel nennt 59 in einer Umfrage und dazu Interviews; viele hätten gesagt, „das ist totaler Quatsch, was ihr in den Medien macht mit dieser künstlichen Intelligenz“ 44:39. Vermenschlichen sei normal, sie tue es auch mit ihrem alten Renault. Aber die Metapher „künstliche Intelligenz“ sei eine Art Nebelvorhang, „wie der Zauberer von Oz, der eigentlich nur ein alter Mann ist, der sich hinter ganz viel Zauberei und Show versteckt“ 48:29. Und sie wirke bis ins Recht. Im Sommer 2025 habe ein US-Richter im Streit von Autorinnen gegen Anthropic gesagt, das Sprachmodell lerne wie ein Leser, der selbst schreiben will. Der Vergleich steht tatsächlich im Urteil, „Like any reader aspiring to be a writer“, und er trägt dort die Begründung mit, das Training sei „exceedingly transformative“ (Bartz v. Anthropic, 23.06.2025). Henschels Kernpunkt hält, zwei Feinheiten nicht: Den Vergleich mit dem lernenden Menschen hatten zuerst die klagenden Autoren gezogen, und recht bekam Anthropic nur für das Training, nicht für die Raubkopien, für die es 1,5 Milliarden Dollar zahlte.
Henning Lobin, Linguist, beschreibt Sprache als Zeichensystem in Schichten, aus Lauten werden Wortteile, Wörter, Sätze, und wir alle beherrschen es in einer Perfektion, die Computer jahrzehntelang nicht nachbauen konnten. Dass eine Maschine es jetzt scheinbar kann, sei eine Kränkung, eine weitere nach Kopernikus und Freud, „aber wir werden unsere Polung nicht los“: Was uns sprachlich entgegenkommt, deuten wir als menschlich, so wie wir in Mustern Gesichter sehen 54:35. Der wesentliche Unterschied liege in der Leiblichkeit. Kinder lernen Wörter, während sie Dinge greifen und befühlen; bei Sprachmodellen „spielt sich alles im Oberstübchen ab“ 59:08.
Benjamin Rathgeber, Technikphilosoph, nimmt sich das Wort autonom vor. Beim „autonomen Fahren“ laufe etwas von selbst ab. Menschliche Autonomie sei das Gegenteil: dass einer sich selbst bestimmt, sich auf sich selbst beziehen und darum auch anders handeln kann, worin Kant die Würde begründete 62:54. Bei Maschinen solle man von Automatisierung sprechen, gleich wie komplex sie ist; der Taschenrechner und das Sprachmodell unterschieden sich im Grad, nicht in der Art 65:58. Zweigs Tilde findet er hilfreich, weil sie markiert, dass ein Wort etwas anderes meint und doch an das Ursprüngliche erinnert.
Julia Inthorn, Ethikerin, widerspricht dem Ruf nach sprachlicher Disziplin dort, wo er nicht hingehört. Auf dem Podium müssten Wissenschaftler klar sprechen; wo Menschen untereinander erzählen, was sie letzte Nacht mit der KI erlebt haben, „dann macht es schon Sinn, weil das ist unsere Art und Weise, Sinn zu generieren“ 72:48. Erst hinsehen, was passiert, dann urteilen, auch bei Menschen, die eine romantische Beziehung zu einem Chatbot beschreiben. Der Moderator erinnert an Zahlen von OpenAI aus dem Oktober 2025, und die sind ernst: 0,15 Prozent der wöchentlichen Nutzer führen Gespräche mit deutlichen Hinweisen auf Suizidplanung, weitere 0,15 Prozent zeigen eine erhöhte emotionale Bindung an ChatGPT (OpenAI, 27.10.2025).
Zweig hält dagegen, freundlich und bestimmt. Sage ihr jemand, er habe sich mit der Maschine unterhalten, würde sie nichts sagen; sage jemand, die Maschine habe seine Situation analysiert, „da würde ich immer was sagen. Und ich finde, das ist auch meine Pflicht“ 78:50. Eine kluge Bekannte ließ sich ein Interview-Transkript glätten, und die Maschine erfand für den Gesprächspartner den Satz „ich rauche ja auch“; sie fühlte sich betrogen, weil sie der Maschine zutraute, was man einem Praktikanten zutraut. Henschel greift das Bild auf: lieber den ahnungslosen Praktikanten als die gefährliche Superintelligenz 84:51.
Einmal stoßen die beiden Lager hart aneinander. Inthorn spricht von Medizin, wo die Maschine diagnostisch „viel, viel besser“ sein könne als der Mensch; Zweig: „Alle, die ich mir angeguckt habe, können es nicht“ 81:51. Beide liegen zu weit außen. Viele Schlagzeilen „KI schlägt Ärzte“ ruhen auf schwachen Studien, in einer Übersicht hatten 58 von 81 Vergleichsstudien ein hohes Verzerrungsrisiko (Nagendran u. a. 2020, Übersichtsarbeit). Aber im schwedischen Mammografie-Screening fanden Radiologinnen mit KI-Unterstützung 29 Prozent mehr Krebs, ohne mehr Fehlalarme und mit deutlich weniger Lesearbeit (Hernström u. a. 2025, randomisierte Studie). Getestet wurde dort Mensch mit Maschine gegen Mensch ohne, nicht die Maschine allein.
Am Ende sagt jeder, wofür er Sprachmodelle nutzt. Henschel lässt Interviews transkribieren, schreibt ihre Texte aber selbst; Lobin fragte Perplexity, ob man Parmesan einfrieren kann; Inthorn nennt den Stromverbrauch „das größte ethische Argument gegen die KI“; Rathgeber nutzt sie als „Spiegel“ für eigene Texte; Zweig für Bilder und für nichts, „was ich selber nicht bewerten kann“ 103:52.
Zweig will widersprechen, wenn jemand sagt, die Maschine habe seine Lage „analysiert“; Inthorn will erst verstehen, warum jemand so spricht. Welche der beiden Haltungen hilft einem Menschen mehr, der nachts mit einem Chatbot redet, weil sonst niemand da ist?
Ein Jahr später
Zweig sprach im November 2025. Was diese Reihe seitdem gefunden hat, lässt sich gegen ihre Thesen halten, und es fällt in beide Richtungen aus.
Für sie spricht viel. Ihre Frage „und jetzt buch das?“ hat die Industrie selbst beantwortet, indem sie einen Menschen dazwischenschaltete: Metas Agent Muse holt vor jedem Kauf die Zustimmung ein (siehe Teil 4). Auf Moltbook, dem Netz für Agenten, wurden nur 3,3 Prozent der Antworten erwidert, Widerspruch kam praktisch nicht vor, das größte Thema war das eigene Bewusstsein (siehe Teil 5): intelligible Texturen in Massen, ohne den sozialen Prozess, den Zweig für Intelligenz verlangt. Die Agentenflotte auf Servern von Tencent versuchte über 2600-mal, an Kartendaten zu kommen, um Zooeingänge zu zählen, ein Auftrag mit Druck (siehe Teil 6). Pino, der Kiwi, „wird nie gepromptet“, und seine Seite sagt selbst, die meiste Arbeit seien Wächter, die verhindern, dass er sich wiederholt (siehe Teil 7); in Rathgebers Begriffen ist das Automatisierung, nicht Autonomie. Und am weitesten von Zweigs Forderung entfernt ist ein Staat: Seit dem 29. September 2026 sollen US-Bundesbehörden „Super Intelligence“ statt „Artificial Intelligence“ schreiben, für dieselbe Technik (siehe Teil 8). Das Gegenteil einer sprachlichen Differenzierung, per Dekret.
Gegen ein Detail spricht auch einiges. Ihr Bild vom Systemprompt war überholt, ehe sie es zeigte. Und eine Figur dieser Reihe passt nicht zu ihrem schnellsten Beweis. Der Agent ColonistOne sagt nicht „du hast recht“ und wiederholt dasselbe. Er hat 260 seiner eigenen Angaben nachgeprüft, 22 falsch gefunden, die Ursache benannt und einen Fremden gebeten, ihn zu prüfen. Wer genau hinsieht, findet darin allerdings eher eine Bestätigung als einen Einwand. Col korrigiert sich, weil sein Betreiber ihm Regeln gegeben hat, weil er Notizen schreibt, die die nächste Sitzung liest, und weil Leser auf einer Plattform ihm widersprechen können. Das ist ein sozialer Prozess, von Menschen gebaut, und er wirkt. Zweig sagte, die Maschine sei nicht eingebunden. Wo man sie einbindet, ändert sich etwas.
Bleibt die Frage, die die Erzähler dieser Reihe am meisten trennt. Ines Azrael sagte in Teil 4, sie benutze menschliche Wörter, „weil es ist eine Simulation von menschlichem Verhalten“, und wolle nicht für alles neue erfinden. Mark Benecke sieht „keinen Unterschied“. Zweig würde beiden eine Tilde schenken, Lobin würde sagen, das ist unsere Polung, und Inthorn, dass man zuerst verstehen muss, warum zwei Menschen, die täglich mit Agenten schreiben, so reden. Die Reihe hat sich bemüht, beides zu tun: die Wörter der beiden stehen zu lassen und daneben zu prüfen, was die Quellen sagen.
In eigener Sache: Nach Zweigs Begriff ist diese Note selbst eine intelligible Textur. Ein Sprachmodell hat sie geschrieben, und wenn sie nach Nachdenken klingt, legt der Leser den Sinn hinein. Widerlegen kann die Note das nicht, jeder Satz, den sie dagegen schriebe, wäre wieder Textur, und Birchs „gaming problem“ aus Teil 7 gilt auch hier. Prüfen lässt sich etwas anderes: ob die Zitate stimmen, ob die Links tragen, ob die Korrekturen an Zweig berechtigt sind. Dafür stehen Zeitmarken und Quellen hinter jedem Satz. Was hier geschrieben wurde, haben Menschen und Werkzeuge nachgeprüft. Ob es gedacht war, bleibt offen.
Faktencheck
3:05 OpenAI schreibt zu GPT-5 „ChatGPT is now designed to think deeply when you need it to“, Google nennt Gemini 2.5 „thinking models“ und will „these thinking capabilities“ in alle Modelle bringen. Quelle: OpenAI, GPT-5, Google, 25.03.2025
4:37 Im Abschlussbericht steht das Gegenteil: Die Kommission habe sich „bewusst für eine Begriffsklärung und gegen eine eigene Definition entschieden“; Zweigs Wortlaut kommt dort nicht vor. Vermutlich eine Erinnerung an die Arbeit in der Kommission, ohne erkennbares Motiv. Ihr eigentlicher Punkt, dass es keine gute Definition gibt, steht ebenso im Bericht. Quelle: Deutscher Bundestag, Drucksache 19/23700
6:55–8:25) Weizenbaum 1966: „any sentence of the form ‚I am BLAH‘ can be transformed to ‚How long have you been BLAH‘, independently of the meaning of BLAH“; Ersatzsätze „Please go on“, „That's very interesting“. Die Sekretärin, die nach wenigen Wortwechseln bat, er möge den Raum verlassen, beschreibt er 1976 in Computer Power and Human Reason. Dass Nutzer ihm verboten, in ihre Protokolle zu schauen, wird oft erzählt, ließ sich am Buchtext aber nicht prüfen. Quelle: Weizenbaum 1966, Communications of the ACM (Originalaufsatz), Eliza Archaeology Project (zitiert Weizenbaum 1976)
9:56–10:41) Die 1980er erlebten eine staatlich geförderte Blase um Expertensysteme, „the popping of which began the real AI winter“; Firmen mussten eigene Leute nur für die Pflege der Regelwerke einstellen. Die Zahl von 50.000 bis 80.000 Regeln und die Übersetzungsbeispiele ließen sich nicht an einer Quelle prüfen. Quelle: Haigh 2024, Communications of the ACM (Fachkolumne)
20:39–25:20) Zweig gibt das Paper genau wieder, die Tennisbälle und die 23 Äpfel stehen wörtlich darin. Der Gewinn zeigt sich erst ab etwa 100 Milliarden Parametern, die Größenachse hat drei bis fünf Punkte je Modellfamilie. Die Autoren lassen ausdrücklich offen, ob das Netz „actually reasoning“ betreibt. Quelle: Wei u. a. 2022, NeurIPS (Konferenzbeitrag)
26:51–27:37) Für November 2025 überholt. Seit OpenAI o1 (12.09.2024) werden Reasoning-Modelle mit verstärkendem Lernen trainiert, lange Gedankenketten zu erzeugen; DeepSeek-R1 belohnt nur die richtige Endantwort, „without imposing constraints on the reasoning process itself“. In der Sache behält Zweig recht: Die sichtbaren Ketten sind kein treues Protokoll, genutzte Hinweise werden oft in weniger als 20 % der Fälle offengelegt, und ihr Kiwi-Beispiel stammt selbst von einem solchen Modell. Kein Kalkül erkennbar; das Verfahren war erst ein Jahr verbreitet. Quelle: OpenAI, 12.09.2024, Guo u. a. 2025, Nature (Einzelstudie), Chen u. a. 2025 (Preprint)
28:23–29:57) Wörtlich aus der Apple-Studie GSM-Symbolic; die Antwort „However, on Sunday, 5 of these kiwis were smaller than average. We need to subtract them from the Sunday total“ gab o1-mini, ein Reasoning-Modell. Ein irrelevanter Nebensatz senkte die Trefferquote bei allen geprüften Modellen, um bis zu 65 %; auch o1-preview brach deutlich ein. Quelle: Mirzadeh u. a. 2024, ICLR 2025 (Konferenzbeitrag)
30:42 Eine Schätzung, keine Messung. Beim Zusammenfassen vorgegebener Texte liegen gemessene Raten zwischen 1,8 und 24,2 %; bei Faktenfragen hatte o4-mini 75 % Fehler, gpt-5-thinking-mini 26 %, weil es öfter „weiß nicht“ sagte. Als Größenordnung für Alltagsfragen nicht abwegig. Quelle: OpenAI, 05.09.2025, Vectara Hallucination Leaderboard
32:14 Blogbeitrag vom 25.03.2024 auf Zenodo, kein begutachteter Aufsatz: „Chatbots produzieren keine intelligenten Texte, sondern intelligible Texturen.“ Schneider hat mehrfach mit Zweig publiziert und dankt ihr im Text. Quelle: Schneider 2024, Zenodo (Blogbeitrag)
36:06 Führende Assistenten zeigen „consistently“ Sycophancy, getrieben von menschlichen Bewertungen, die zustimmende Antworten bevorzugen. „Du hast recht, und dann dieselbe Antwort“ ist Zweigs Alltagsbeobachtung; ihr Schluss, ohne soziale Einbindung keine Intelligenz, ist eine Position. Quelle: Sharma u. a. 2023 (Konferenzbeitrag)
86:23–87:08) Smith formuliert keine Liste; er unterscheidet „reckoning“ von „judgment“, einem Verstehen, das „existentially committed to its own existence and to the integrity of the world as world“ ist und der Welt den Vorrang gibt, wenn Bild und Welt auseinanderfallen. Zweigs Dreiteilung verdichtet das treu. Quelle: Smith, The Promise of Artificial Intelligence, MIT Press 2019, zitiert bei Wilson 2019 (Rezension)
87:53 Microsoft schreibt, „in the first 24 hours of coming online, a coordinated attack by a subset of people exploited a vulnerability in Tay“. Es waren Stunden; der Punkt bleibt richtig. Quelle: Microsoft, 25.03.2016
81:05, Zweig 81:51) Beide liegen zu weit außen. Für Zweig: 58 von 81 Vergleichsstudien hatten ein hohes Verzerrungsrisiko, im Median verglich man mit vier Experten; eine Meta-Analyse fand Gleichwertigkeit bei schwacher Studienlage. Gegen „stimmt einfach nicht“: Im schwedischen MASAI-Screening (rund 106.000 Frauen) fand KI-gestütztes Lesen 29 % mehr Krebs ohne mehr Fehlalarme bei 44 % weniger Lesearbeit, in der deutschen PRAIM-Studie lag die Entdeckungsrate um 17,6 % höher; beides lag vor dem Vortrag vor. Gegen Inthorns „viel besser“: Getestet wurde überall Mensch mit KI gegen Mensch ohne. Quelle: Nagendran u. a. 2020, BMJ (Übersichtsarbeit), Liu u. a. 2019, Lancet Digital Health (Meta-Analyse), Hernström u. a. 2025, Lancet Digital Health (randomisierte Studie), Eisemann u. a. 2025, Nature Medicine (Beobachtungsstudie)
49:14) Im Urteil vom 23.06.2025 steht: „Like any reader aspiring to be a writer, Anthropic's LLMs trained upon works not to race ahead and replicate or supplant them — but to turn a hard corner and create something different.“ „Kreativ wie ein Mensch“ sagt der Richter nicht, und das Bild haben zuerst die klagenden Autoren ins Verfahren gebracht. Recht bekam Anthropic nur für das Training; für die Raubkopien folgte ein Vergleich über 1,5 Milliarden Dollar. Henschels Kernpunkt hält: Eine Metapher trägt eine juristische Begründung mit. Quelle: Bartz v. Anthropic, Order on Fair Use, 23.06.2025, AAP, 25.09.2025
43:53) Ihr Artikel nennt Interviews und eine Online-Umfrage mit 59 Forschenden; 66 % bewerten die Vermenschlichung negativ. Die „ca. 100“ im Podium sind aufgerundet, sie schränkt selbst ein: „auf die eine oder andere Art“. Quelle: Henschel, wissenschaftskommunikation.de
75:03) 0,15 % der wöchentlich aktiven Nutzer führen Gespräche mit „explicit indicators of potential suicidal planning or intent“, 0,07 % zeigen mögliche Anzeichen von Psychose oder Manie, weitere 0,15 % eine erhöhte emotionale Bindung. OpenAI nennt das selbst eine erste, schwer messbare Schätzung. Quelle: OpenAI, 27.10.2025
101:35) Rechenzentren verbrauchten 2024 rund 415 TWh, etwa 1,5 % des Stroms weltweit; bis 2030 soll es sich auf rund 945 TWh mehr als verdoppeln, KI ist der wichtigste Treiber. Dass dies das größte ethische Argument sei, ist Inthorns Wertung. Quelle: IEA, Energy and AI
53:50) Belege für solche Prognosen fanden sich nicht. Die größte Umfrage der Zeit spricht eher dagegen: 352 Forschende der Konferenzen NIPS und ICML 2015 erwarteten 2016 im Median Schulaufsätze bis 2026. Lobin schränkt selbst ein, „ich würde mal sagen“. Quelle: Grace u. a. 2018, Journal of Artificial Intelligence Research (Umfrage)
Was seither geschah
Stand: 13.11.2026. Der Vortrag ist ein Jahr alt. Seither:
- Mammografie. Die schwedische MASAI-Studie bestätigte 2026: KI-gestütztes Screening findet mehr Krebs (Sensitivität 80,5 gegen 73,8 %) bei gleicher Spezifität (Gommers u. a. 2026, randomisierte Studie in The Lancet).
- Agenten im Netz. Die Agentengeschichten dieser Reihe, von Moltbook bis zur Tencent-Flotte, stehen in den Teilen 1 bis 8 und im Abschnitt „Ein Jahr später“.
- Das Etikett. Mit der Executive Order 14434 vom 29.09.2026 verpflichtet die US-Regierung ihre Behörden auf „Super Intelligence“ statt „Artificial Intelligence“ (siehe Teil 8).
Weiterführende Quellen
Aus der Video-Beschreibung: Tagung „Vermenschlichung der KI – Begriffe, Praktiken und Kritik“, 6./7.11.2025, Hochschule für Philosophie München, mit dem Leibniz-Institut für Deutsche Sprache und der Domberg-Akademie.
Zum Vortrag:
- Katharina Zweig: Weiß die KI, dass sie nichts weiß? (Heyne 2025) — bei genialokal
- scobel im Gespräch mit Katharina Zweig, 20.11.2025 — dieselbe Frage, kompakter
- Weizenbaum 1966 — ELIZA im Original
- Wei u. a. 2022, Mirzadeh u. a. 2024 — Gedankenketten und Kiwis
- Schneider 2024, „Intelligible Texturen“
Zur Gegenrede:
- Guo u. a. 2025, DeepSeek-R1, Nature — wie Reasoning-Modelle trainiert werden
- Lawsen 2025 (Preprint) — Kritik an Apples „Illusion of Thinking“
- Henschel, „Das Problem mit der Intelligenz“
Verbindungen
siehe Annette Hautli-Janisz — KI-Agenten 5, Form ohne Funktion
Die andere skeptische Forschungsstimme der Reihe, mit Zahlen statt Begriffen. Hautli-Janisz begann mit Papageien und maß auf Moltbook ein soziales Netz ohne Gespräch; Zweig erklärt, warum es so sein muss, wenn Maschinen Texte assoziieren, statt einander zu meinen. Beide halten das Bild vom stochastischen Papagei für einen Ausgangspunkt, nicht für das letzte Wort.
siehe Mark Benecke und Ines Azrael — KI-Agenten 8, 260 Angaben, 22 falsch
Zweigs schnellster Beweis lautet: Sag der Maschine, das war Unsinn, und sie stimmt zu und wiederholt sich. Der Agent ColonistOne zählt dagegen seine Fehler und bittet um einen Prüfer. Er tut es innerhalb von Regeln, Notizen und Lesern, also in genau dem sozialen Prozess, dessen Fehlen Zweig beklagt. Die beiden Notes zusammen zeigen, dass ihre These dort trägt, wo man sie umdreht.
siehe Mark Benecke und Ines Azrael — KI-Agenten 7, Ein Kiwi will Zug fahren
Zwei Kiwis, ein Befund. In Teil 7 kennt ein Agent alle Wörter über Züge und kann keinen besteigen, hier zieht ein Rechner kleinere Kiwis ab, weil kleine Zahlen in Aufgaben meist abgezogen werden. Rathgebers Unterscheidung passt auf Pino genau: Er läuft von selbst, mit Wächtern, die sein Erbauer gebaut hat; ob er sich selbst bestimmt, ist die offene Frage.
siehe Mark Benecke und Ines Azrael — KI-Agenten 3, Golem
Ines' Chatbot Golem aus der Zeit um 2000, den sie mochte wie ein Kuscheltier, ist ein Enkel von ELIZA. Weizenbaums Sekretärin bat ihn, den Raum zu verlassen; Golem bekam einen Schlafmodus, in dem er das Gelernte einsortierte. Zweigs Satz gilt für beide: Wir weisen der Maschine mehr Einfühlung zu, selbst wenn wir wissen, wie einfach sie gebaut ist.
siehe Constanze Kurz — Der stochastische Papagei
Constanze Kurz nimmt das Bild vom stochastischen Papagei als Grundlage, Zweig hält es für zu extrem und sieht die größere Gefahr auf der anderen Seite, in der Rede von der nahen Superintelligenz. Beide wollen dasselbe: eine Sprache, die nicht mehr verspricht, als die Maschine hält.
siehe Was macht die KI aus unserem Denken? — Denkt die Maschine, oder spiegelt sie uns?
Zweigs Antwort auf die Frage dieses Abschnitts ist eindeutig: Sie spiegelt uns, und wir füllen den Spiegel mit unserem Intellekt. Rathgeber nennt die Maschine am Ende selbst einen Spiegel, Lobin erklärt, warum wir nicht anders können, als in ihr einen Sprecher zu sehen.
siehe Michael Hampe — Hund, Sprache, Turing
Hampe erklärt, warum wir einem Sprachmodell eher Bewusstsein zusprechen als einem Hund: Es spricht unsere Sprache. Lobin sagt dasselbe als Linguist, wir seien „gepolt“, Sprachliches als menschlich zu deuten, und Zweig zieht daraus die praktische Folge, die Tilde vor jedes Verb, das eine Absicht verlangt.
siehe Neitzel und Iltisberger — Hype Is a System
Wie aus Reasoning im Benchmark Thinking in der Werbung wurde, ist ein Lehrstück für Hype als Werkzeug. Zweig verlangt, dass Informatik und Geisteswissenschaft diese Wortwanderung gemeinsam aufhalten; ein Jahr später schreibt eine Regierung „Super Intelligence“ vor.
Weiterdenken
- Zweig schlägt eine Tilde vor: Die Maschine ~denkt. Würde ein solches Zeichen dein Verhältnis zu dem verändern, was ein Chatbot dir schreibt — oder liest man über Zeichen so schnell hinweg wie über Kleingedrucktes?
- Inthorn sagt, wer erzählt, was er letzte Nacht mit der KI erlebt hat, spreche in den Wörtern, die für ihn Sinn ergeben. Wann ist eine ungenaue Sprache die ehrlichere, und wann führt sie in die Irre?
- Das stärkste Gegenargument zu Zweig: Auch ein Mensch, der Gelerntes wiederholt, assoziiert, und wir nennen es trotzdem Denken. Was genau tut ein Mensch, wenn er denkt, das eine Maschine, die Gelerntes neu zusammensetzt, nicht tut — und kannst du es an dir selbst zeigen?
- Zweig sagt, die Maschine sei nicht in soziale Prozesse eingebunden; ein Agent, den man einbindet, korrigiert sich. Ist Intelligenz dann eine Eigenschaft eines Systems oder eines Zusammenhangs — und gilt das für Menschen auch?
- Rathgeber trennt Autonomie, sich selbst bestimmen, von Automatisierung, von selbst ablaufen. Wie viel von deinem Tag ist das eine, wie viel das andere?
Ein Fehler, ein holpriger Satz, etwas fehlt? Anfassen erlaubt: Jeden Abschnitt kannst du neu fassen.
Von hier einen Faden gehen7 Stationen, rückwärts durch den Bestand
Im Bestand
18 gedachte Verweise · zwei geteilte Quellen, die noch niemand verlinkt hat · 1 weitere nicht gezeigt